Check e dipendenze
Definire cosa controllare, come i servizi dipendono dall’infrastruttura e quali eventi richiedono un intervento.
Riccardo Corsanici · Take Two
Controllo operativo di reti, sistemi e servizi. Informazioni leggibili per le risorse tecniche e per chi deve decidere.
Monitoring & dashboard
Un allarme serve se arriva alla risorsa giusta e aiuta a prendere una decisione.
Con Nagios e Icinga lavoriamo sul monitoraggio di host, servizi e dipendenze: check utili, soglie coerenti e notifiche organizzate. La gestione degli alert deve accompagnarsi a responsabilità definite e procedure di escalation.
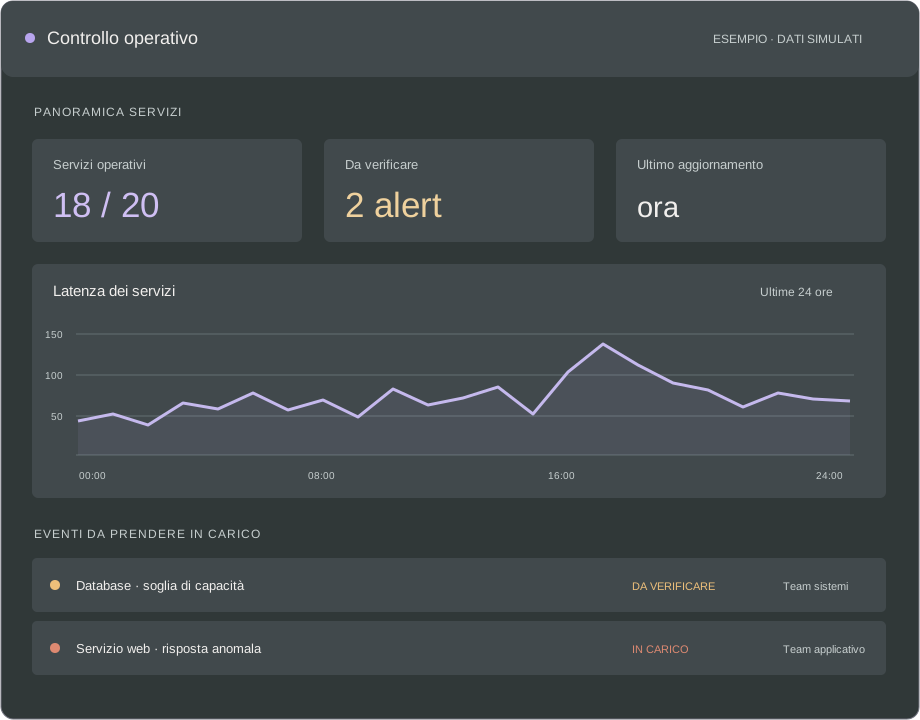
Le dashboard collegano le informazioni tecniche alle esigenze operative. Disponibilità, anomalie, capacità e criticità devono essere leggibili, sia per chi gestisce i sistemi sia per chi segue il progetto.
Definire cosa controllare, come i servizi dipendono dall’infrastruttura e quali eventi richiedono un intervento.
Impostare soglie coerenti e procedure di escalation, con responsabilità chiare per la presa in carico.
Riunire stato dei servizi, anomalie, capacità ed eventi rilevanti in una vista adatta agli operatori e ai responsabili di progetto.
Mantenere i check allineati all’evoluzione dei sistemi e collegare il monitoring a inventario, applicazioni e procedure.
Confrontiamoci sul contesto e sul supporto che ti serve.
Esperienza sui progetti di monitoring ↗